두 사람이 한국어로 대화하는 영상 만드는 법 🍁
캐릭터 시트 두 장과 10초 대화 보이스로, 가을 산길을 함께 걷는 두 사람의 대화 영상을 만듭니다.
- 캐릭터 시트 · GPT Images 2.5
- 장면 이미지 · GPT Images 2.5
- 대화 보이스 · Eleven v4
- 영상 · Seedance 2.5
- 업스케일 · Topaz Starlight
완성 영상 · 16:9 · 1080p · 10초
01캐릭터 시트 두 장 만들기 – GPT Images 2.5
두 사람의 얼굴과 스타일을 고정하기 위해 인물마다 캐릭터 시트를 한 장씩 만듭니다. 남성 시트는 여성 시트를 레퍼런스로 넣고 같은 구성, 같은 조명으로 만들어 두 장의 분위기를 맞췄습니다.
- 나이, 분위기, 헤어, 의상을 구체적으로 묘사합니다.
- 한 장 안에 대표 컷, 표정 컷, 전신 컷, 정면·측면·뒷모습을 함께 담도록 요청합니다.
- 두 번째 인물은 첫 번째 시트를 레퍼런스로 넣고 "같은 레이아웃, 다른 인물"이라고 적습니다. 얼굴은 따라 하지 않도록 분명히 적어 둡니다.
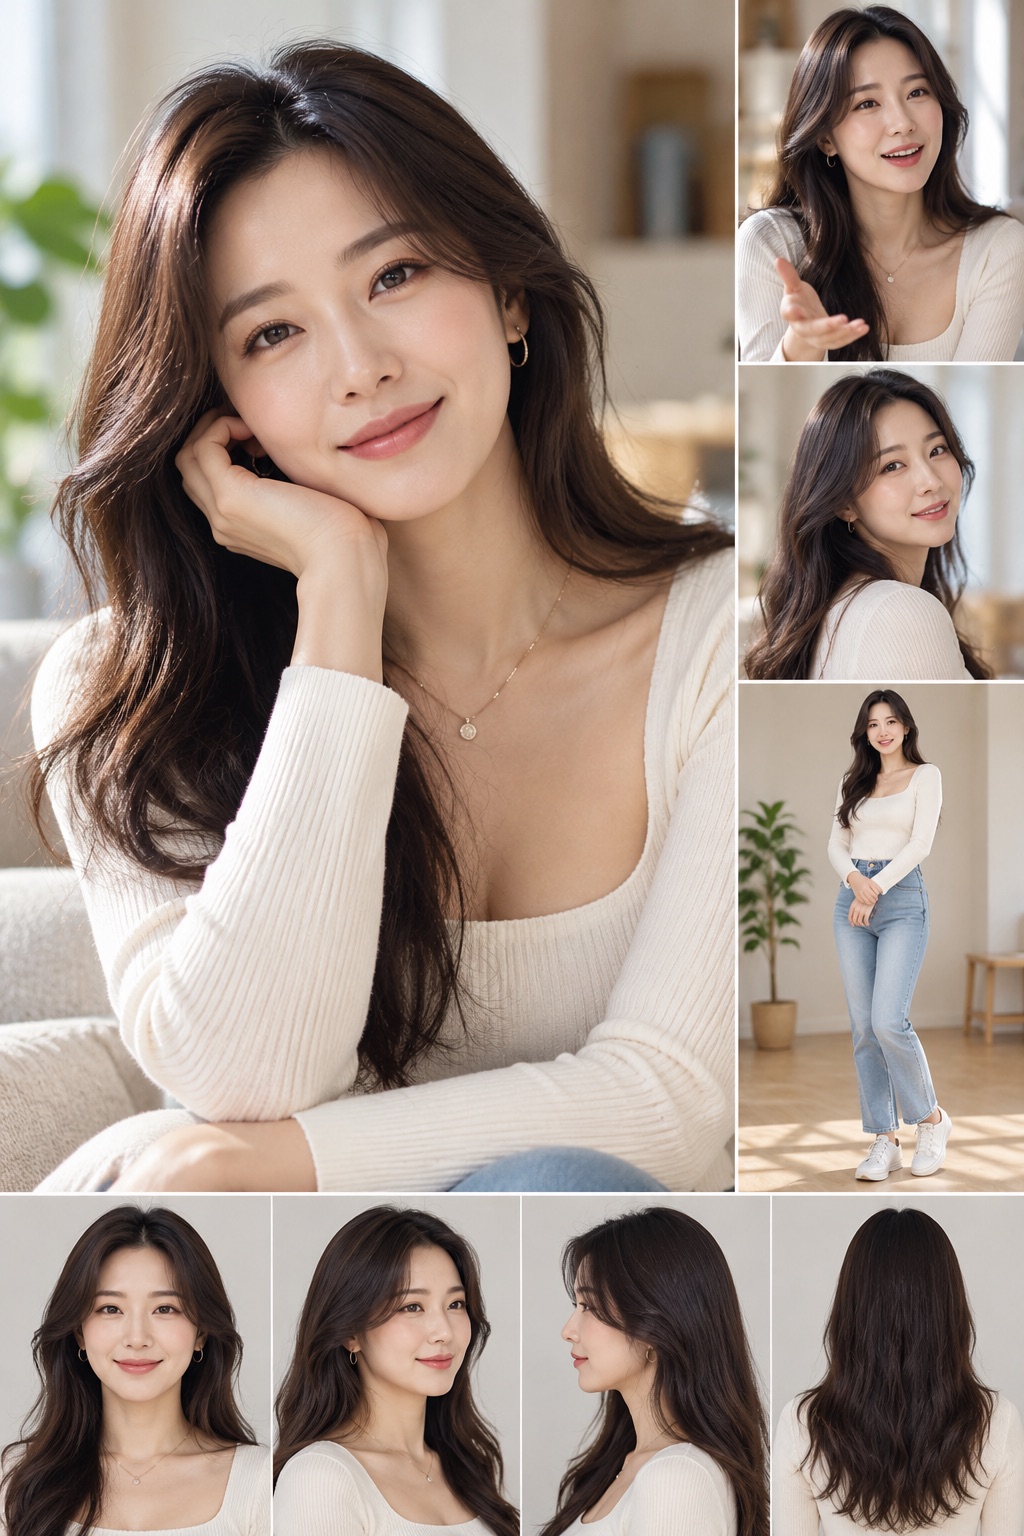
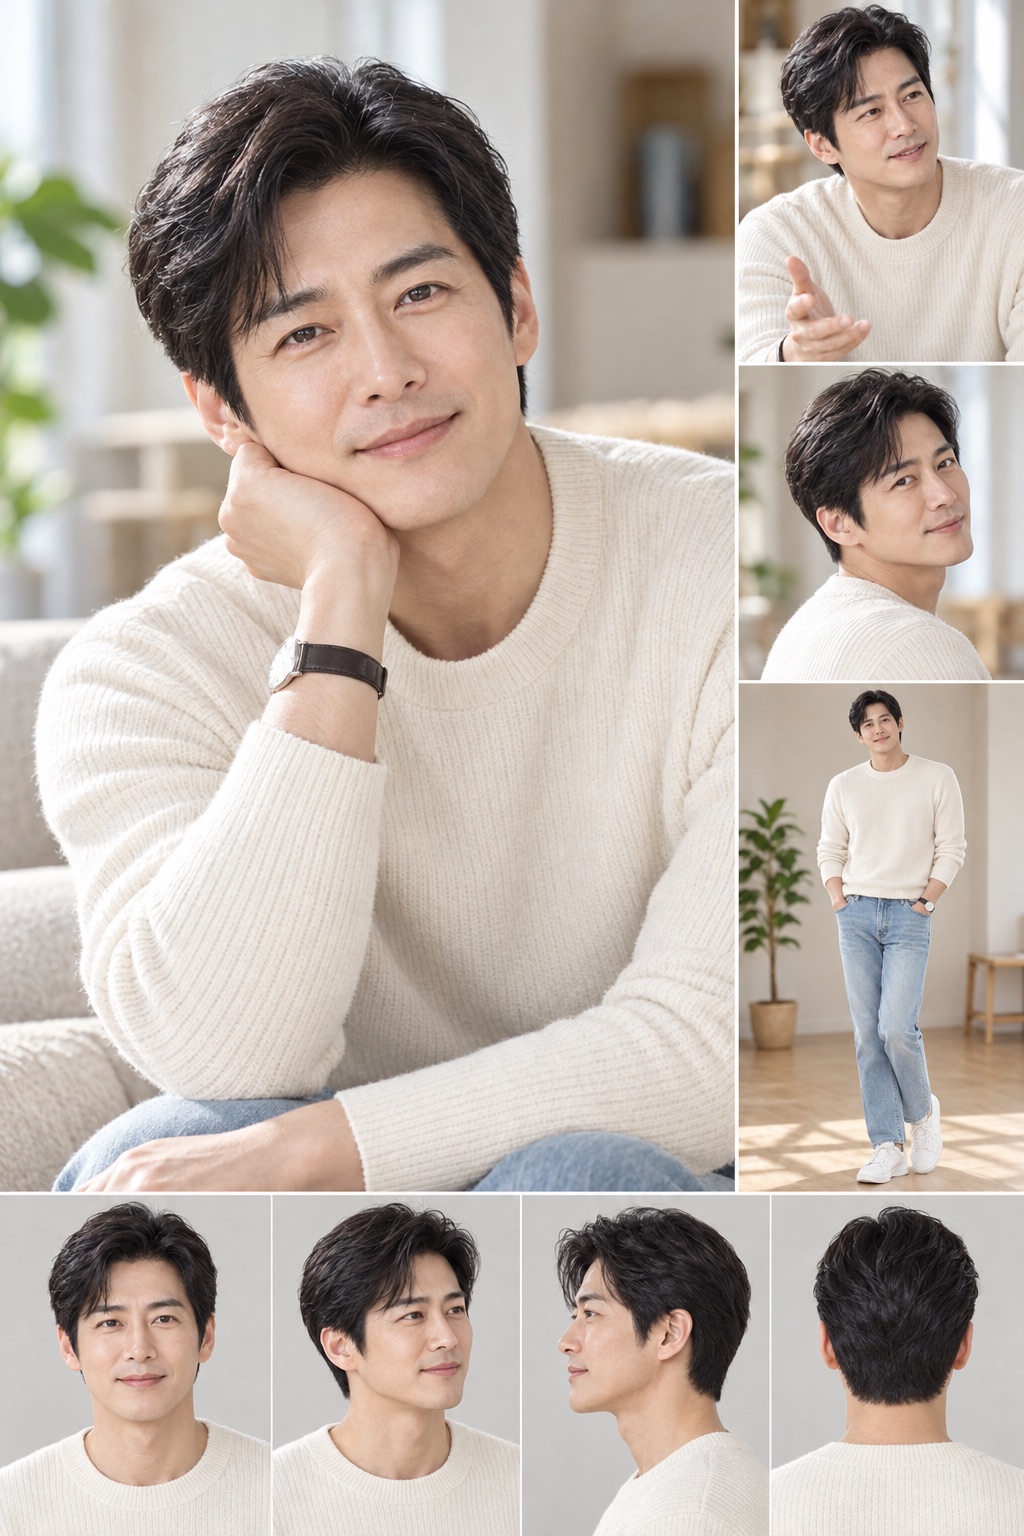
처음 만든 남성 시트는 희끗한 머리에 수염이 있었습니다. "검은 머리, 수염 없이"라고 고쳐 다시 만들었습니다. 마음에 들 때까지 시트를 고치는 것이 가장 싸고 빠릅니다.
02두 사람이 함께 있는 장면 – GPT Images 2.5
두 캐릭터 시트를 레퍼런스로 넣어, 영상의 첫 장면이 될 이미지를 만듭니다. 영상 비율과 같은 16:9로 만듭니다.
| 모델 | GPT Images 2.5 (Magnific) |
| 레퍼런스 | 첫 번째: 여성 시트 · 두 번째: 남성 시트 |
| 비율 | 16:9 |
프롬프트
A candid, photorealistic photo of the man from the second reference image and the woman from the first reference image hiking together on a scenic mountain trail. Keep both of their faces, hairstyles and features exactly as in the references (the man has short thick black hair and is clean-shaven; the woman has long dark brown wavy hair). They walk side by side, smiling at each other, wearing casual outdoor hiking clothes and small backpacks. Autumn forest and mountain ridges in the background, warm natural afternoon sunlight. Full color.
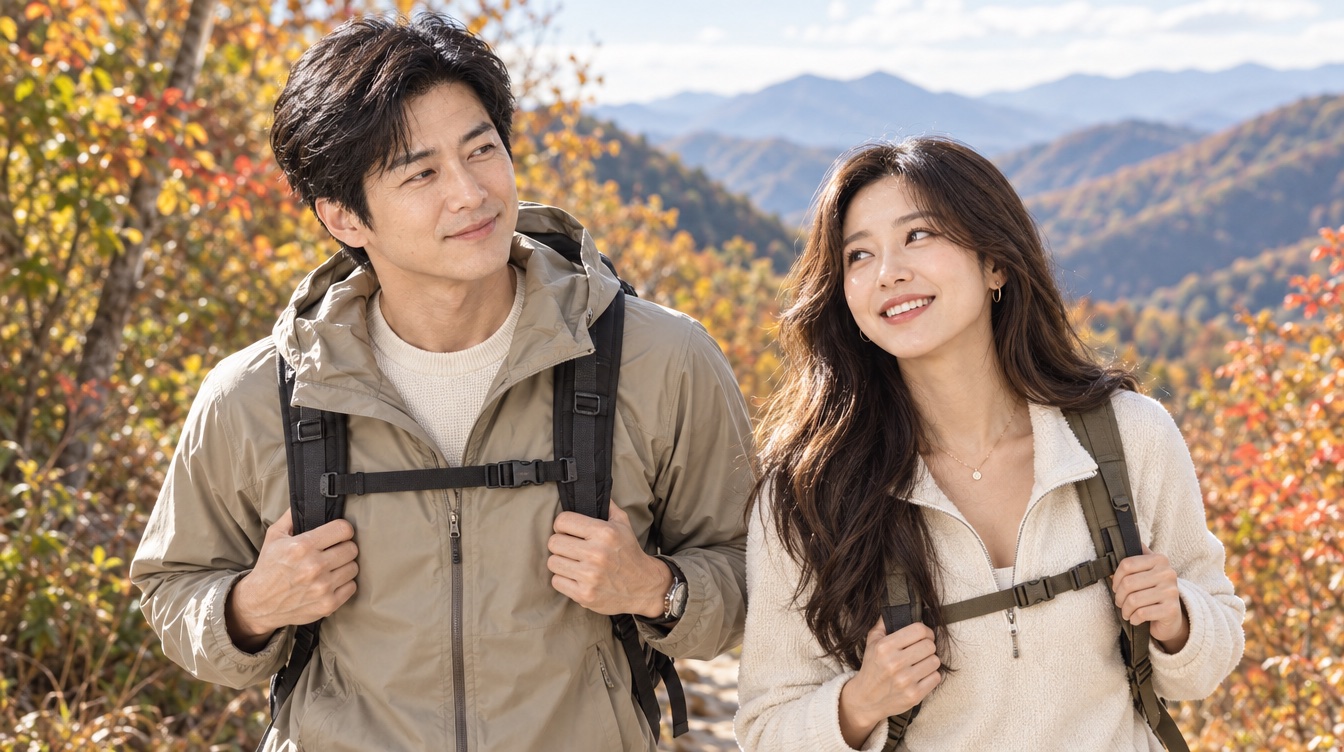
프롬프트에서 "첫 번째 레퍼런스", "두 번째 레퍼런스"로 누가 누구인지 짚어 주고, 헤어처럼 눈에 띄는 특징을 한 번 더 적으면 두 사람이 섞이지 않습니다.
0310초 대화 보이스 – Eleven v4
ElevenLabs에서 남성 보이스와 여성 보이스를 하나씩 정하고, 대사를 한 줄씩 따로 생성한 뒤 순서대로 이어 붙입니다.
| 여성 | 이거 누구 아이디어였더라? |
| 남성 | 당신이지. 쉬운 코스라며. |
| 여성 | 쉬운 거 맞아... 산양한테는. |
| 남성 | 저기 봐, 단풍 진짜 예쁘다. |
- 모델을 Eleven v4로, 언어를 한국어로 설정합니다.
- 한 줄씩 그 사람의 보이스로 생성합니다. 줄마다 몇 개를 만들어 가장 자연스럽고 짧은 것을 고릅니다.
- 앞뒤 무음을 잘라 내고 0.1초 간격으로 이어 붙입니다.
- 10초가 넘으면 전체 속도를 살짝 올려 10초에 맞춥니다.
대사와 감정 태그
여성: [breathless] [laughs] 이거 누구 아이디어였더라?
남성: [chuckles] 당신이지. 쉬운 코스라며.
여성: [mischievously] 쉬운 거 맞아... [laughs] 산양한테는.
남성: [laughs] [warmly] 저기 봐, 단풍 진짜 예쁘다.
실제로 사용한 대화 보이스 · 약 10초
0410초 대화 영상 – Seedance 2.5
장면 이미지와 대화 보이스를 레퍼런스로 넣고, 프롬프트에 누가 몇 초에 무슨 말을 하는지 적어 줍니다. 이 영상은 Magnific에서 Seedance 2.5로 만들었습니다.
설정
| 모델 | Seedance 2.5 |
| 레퍼런스 | 장면 이미지 + 대화 보이스 (오디오) |
| 비율 · 해상도 | 16:9 · 720p |
| 길이 | 10초 |
| 사운드 | 켬 |
프롬프트
Use the reference image for the two people, their faces, clothes, backpacks and the autumn mountain trail. Use the reference audio as the exact dialogue and voices, in this order.

0–2.2s: the WOMAN (right, long dark hair, cream jacket) speaks, breathless and laughing: "이거 누구 아이디어였더라?" while the man listens and smiles.

2.2–4.7s: the MAN (left, short black hair, beige jacket) answers with a chuckle: "당신이지. 쉬운 코스라며." while the woman listens.

4.7–7.0s: the WOMAN teases playfully: "쉬운 거 맞아... 산양한테는." and laughs.

7.0–10s: the MAN laughs warmly and gestures toward the view: "저기 봐, 단풍 진짜 예쁘다."

Only the person speaking moves their lips; the listener stays quiet. They walk slowly side by side, turning their faces toward each other in three-quarter view so both faces stay clearly visible to the camera, with natural open-mouth speech and real expressions. Medium shot, slow backward tracking camera, warm afternoon sunlight. Keep both faces identical to the reference image.
시간을 나눌 때는 보이스 파일에서 대사 사이의 쉼이 실제로 몇 초에 있는지 확인해 그대로 적습니다. 화자는 "왼쪽 남성", "오른쪽 여성"처럼 화면 위치로 지정하면 입이 엉뚱한 사람에게서 움직이지 않습니다.
목소리는 Eleven v4 그대로인가요?
아닙니다. Seedance는 오디오 레퍼런스를 분위기와 말의 리듬을 잡는 가이드로만 쓰고, 목소리는 직접 새로 만듭니다. 그래서 완성 영상의 목소리와 대사 타이밍은 voice.mp3와 조금 다릅니다.
이번에는 립싱크를 따로 하지 않고, 대화 보이스를 레퍼런스로만 넣었습니다. 완성 영상의 목소리는 Seedance가 voice.mp3를 참고해 만든 목소리입니다.
051080p 업스케일 – Topaz Starlight Precise 2.6
720p로 만든 영상을 Topaz Labs에서 1080p로 업스케일합니다. 원본에 가깝게 선명도만 올려 주는 Precise 모델을 사용했습니다.
| 작업 | Precise Upscale |
| 모델 | Starlight Precise 2.6 |
| Sharpness | 5 |
| 해상도 · 프레임 | 1080p · 24 FPS |
| 프레임 보간 | None |
| 출력 | SDR · H.264 |
같은 Starlight Precise 2.6을 Magnific에서도 돌려 비교해 보았습니다. Topaz Labs 쪽이 원본 색감에 더 가깝고 피부가 자연스러웠으며, 비트레이트도 약 2.6배 높아 단풍과 머리카락의 디테일이 더 잘 남았습니다.
06파일 내려받기
직접 따라 해 볼 수 있도록 실제로 사용한 파일을 공유합니다.