Mac mini M4에서 mlx-lm으로 Qwen3.5 9B 돌리기
제 Mac mini는 Apple이 파는 가장 저렴한 모델, 메모리 16GB의 기본형 M4입니다. 집 네트워크에 연결해 두고 집 안의 다른 Mac에서 보내는 질문에 답하게 했습니다. 클라우드도, 토큰당 요금도 없습니다. 원래는 Ollama로 모델을 돌렸습니다. 그러다 Apple의 mlx-lm으로 바꾸었더니 같은 모델이 더 빠르고 가벼워졌습니다. 거기에 직접 만든 작은 스크립트 m4.sh로 속도를 한 번 더 끌어올렸습니다.
m4.sh로 Mac mini에 한국어 질문 하나를 보냈고, 초당 21토큰으로 5.5초 만에 답이 왔습니다.16 → 22 tok/s
9.1 → 5.2GB
직접 만든 런처 사용
m4.sh로 받은답변 전체
mlx-lm이란?
MLX는 Apple의 머신러닝 연구팀이 Apple 실리콘(M1~M4 등)을 위해 만든 오픈 소스 머신러닝 프레임워크입니다. CPU와 GPU가 같은 메모리를 함께 쓰는 Apple 실리콘의 통합 메모리 구조에 맞춰 설계되어, 데이터를 옮기는 낭비 없이 GPU로 계산합니다.
mlx-lm은 그 MLX 위에서 대규모 언어 모델(LLM)을 실행하는 공식 패키지입니다. 명령 한 줄로 Hugging Face의 모델을 내려받아 대화하거나, 4비트처럼 작게 줄인(양자화) 모델을 만들거나, 직접 미세 조정(파인 튜닝)할 수 있습니다. 이 글에서 쓰는 mlx_lm.server도 mlx-lm에 들어 있는, OpenAI API와 같은 형식으로 답하는 서버입니다.
공식 사이트: github.com/ml-explore/mlx-lm · MLX 문서: ml-explore.github.io/mlx · MLX용 모델 모음: huggingface.co/mlx-community
구성
| 항목 | 사용한 것 |
|---|---|
| 컴퓨터 | Mac mini, Apple M4(기본형), 통합 메모리 16GB, macOS 27 |
| 런타임 | mlx-lm 0.32.2, MLX 0.32.4 (Apple 실리콘용 Apple의 머신러닝 프레임워크) |
| 모델 | Hugging Face의 mlx-community/Qwen3.5-9B-4bit, 디스크 약 5.6GB, 텍스트 전용 |
| 서버 | mlx_lm.server, 8080 포트의 OpenAI 호환 HTTP API |
| 상시 실행 | macOS LaunchDaemon이 부팅 때 시작하고, 멈추면 다시 띄웁니다 |
| 클라이언트 | curl, OpenAI SDK, 직접 만든 터미널 명령 m4.sh, OpenCode |
Ollama에서 mlx-lm으로
저는 2026년 11월 20일까지 이 Mac에서 Ollama를 썼습니다. 그날 Ollama를 지우고, 같은 Qwen3.5 9B 모델의 4비트 텍스트 전용 버전을 mlx-lm으로 돌리기 시작했습니다. 답변 속도는 약 35% 빨라졌고, 모델이 쓰는 메모리는 약 4GB 줄었습니다. 16GB짜리 컴퓨터에서 이 4GB는 큰 차이입니다. 모델이 여유 있게 올라가느냐, macOS가 스왑을 시작하느냐가 여기서 갈립니다.
| Ollama | mlx-lm | |
|---|---|---|
| 모델 이름 | qwen3.5:9b-mlx | mlx-community/Qwen3.5-9B-4bit |
| 파라미터 수 | 9.4B | 9.4B |
| 양자화 형식 | NVFP4 | 4비트 |
| 디스크 크기 | 8.9GB | 5.6GB |
| 생성 속도 | ~16 tok/s | ~22 tok/s |
| 프롬프트 읽기(prefill) | ~220 tok/s | ~220 tok/s |
| 실행 중 메모리 | ~9.1GB | 5.2GB |
| Mac 전체 메모리 사용 | ~15GB / 16GB | ~13GB / 16GB |
| 이미지 입력 | 가능 | 불가 (필요하면 mlx_vlm.server) |
같은 Qwen3.5 9B 모델인데도 파일 크기가 크게 다릅니다. Ollama 버전은 이미지 처리 기능까지 들어 있는 NVFP4 형식이고, mlx-lm에서 쓰는 버전은 텍스트 전용 4비트 형식입니다.
모델은 16GB에 들어가는 MLX 모델 9개 중에서 골랐습니다. 1위가 Qwen3.5 9B였고, Ministral 3 14B와 Gemma 4 12B가 그 뒤를 이었습니다. 포기한 것은 이미지 입력 하나입니다.
설치 과정
Python 가상 환경을 만들고 mlx-lm 설치하기
Homebrew 업데이트에 영향을 받지 않도록 별도의 가상 환경에 설치합니다.
brew install python@3.12
python3.12 -m venv ~/mlx-env
~/mlx-env/bin/pip install mlx-lm
모델을 내려받고 한 번 실행해 보기
처음 실행하면 약 5.6GB가
~/.cache/huggingface/hub에 내려받아집니다.~/mlx-env/bin/mlx_lm.generate \ --model mlx-community/Qwen3.5-9B-4bit \ --prompt "Say hello in one sentence."
답변 뒤에 생성 속도와 최대 메모리 사용량이 출력됩니다. 초당 22토큰, 5.2GB라는 수치가 여기서 나왔습니다.
LaunchDaemon으로 상시 실행하기
아래 내용을
/Library/LaunchDaemons/com.mlx-lm.server.plist로 저장하고,you를 자신의 사용자 이름으로 바꿉니다. 내 계정 권한으로 실행되고, 아무도 로그인하지 않아도 부팅 때 시작되며, 멈추면 다시 실행됩니다.HF_HUB_OFFLINE=1은 시작할 때마다 Hugging Face에 접속하지 않게 합니다.<?xml version="1.0" encoding="UTF-8"?> <!DOCTYPE plist PUBLIC "-//Apple//DTD PLIST 1.0//EN" "http://www.apple.com/DTDs/PropertyList-1.0.dtd"> <plist version="1.0"> <dict> <key>Label</key><string>com.mlx-lm.server</string> <key>UserName</key><string>you</string> <key>ProgramArguments</key> <array> <string>/Users/you/mlx-env/bin/mlx_lm.server</string> <string>--model</string><string>mlx-community/Qwen3.5-9B-4bit</string> <string>--host</string><string>0.0.0.0</string> <string>--port</string><string>8080</string> <string>--max-tokens</string><string>8192</string> <string>--temp</string><string>0.7</string> <string>--top-p</string><string>0.8</string> <string>--top-k</string><string>20</string> <string>--chat-template-args</string><string>{"enable_thinking":false}</string> </array> <key>EnvironmentVariables</key> <dict> <key>HOME</key><string>/Users/you</string> <key>HF_HUB_OFFLINE</key><string>1</string> </dict> <key>RunAtLoad</key><true/> <key>KeepAlive</key><true/> <key>StandardOutPath</key><string>/Users/you/Library/Logs/mlx-lm-server.log</string> <key>StandardErrorPath</key><string>/Users/you/Library/Logs/mlx-lm-server.log</string> </dict> </plist>샘플링 값(temperature 0.7, top-p 0.8, top-k 20)은 Qwen이 비추론(non-thinking) 모드에 권장하는 값입니다. 초당 22토큰인 컴퓨터에서는 추론 모드가 대기 시간을 몇 배로 늘리기 때문에 기본으로 꺼 두었습니다.
시작하고 확인하기
sudo launchctl bootstrap system /Library/LaunchDaemons/com.mlx-lm.server.plist
curl -s http://localhost:8080/v1/models
재부팅하면 macOS가 켜지고 약 35초 뒤부터 서버가 다시 응답합니다.
서버에 질문하기
서버가 OpenAI API 형식을 쓰기 때문에 클라이언트 쪽에 특별한 준비가 필요 없습니다. 같은 네트워크의 어느 컴퓨터에서든 됩니다.
curl http://mini-m4:8080/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{"model":"mlx-community/Qwen3.5-9B-4bit",
       "messages":[{"role":"user","content":"안녕하세요"}],
       "max_tokens":200}'
from openai import OpenAI
client = OpenAI(base_url="http://mini-m4:8080/v1", api_key="none")
r = client.chat.completions.create(
model="mlx-community/Qwen3.5-9B-4bit",
messages=[{"role": "user", "content": "안녕하세요"}])
print(r.choices[0].message.content)요청 하나에만 추론 모드를 켜려면 JSON에 "chat_template_kwargs": {"enable_thinking": true}를 추가합니다.
직접 만든 스크립트 m4.sh
평소 질문용으로 m4.sh라는 터미널 클라이언트를 만들었습니다. 의존성 없는 Python 파일 하나입니다. 서버에 직접 요청하기 때문에, 코딩 에이전트가 매번 보내는 약 9,300토큰의 시스템 프롬프트를 건너뜁니다. OpenCode에서 23초 걸리던 달 거리 질문이 m4.sh로는 5.5초면 끝납니다.
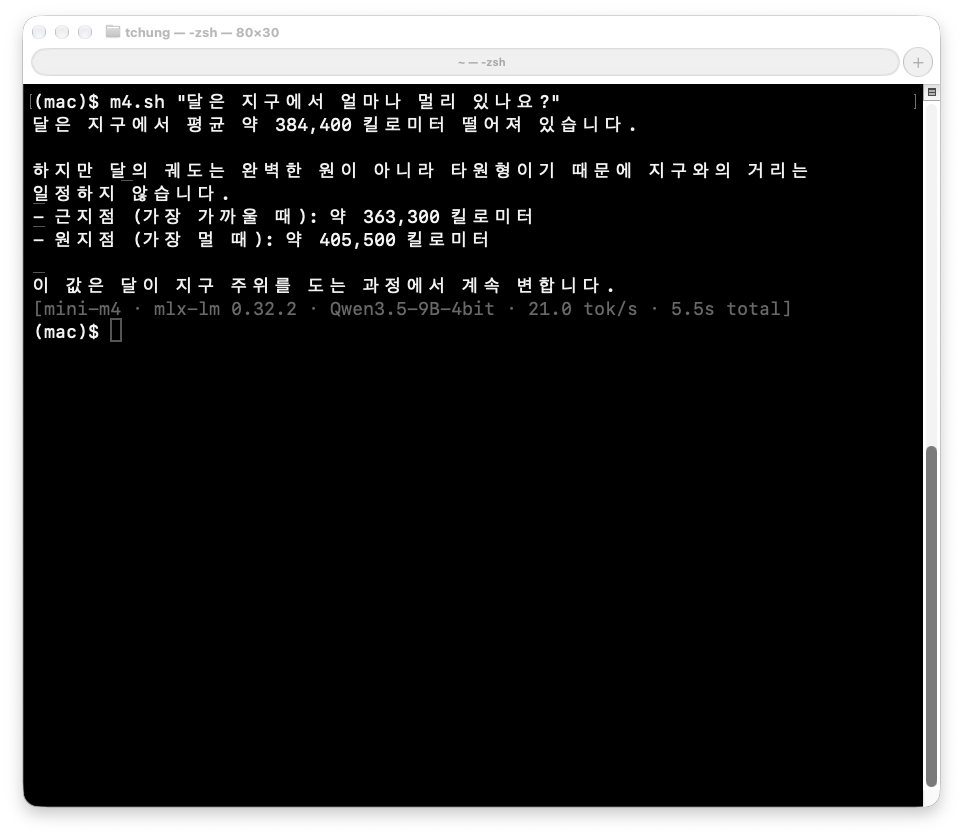
m4.sh가 매번 출력하는 흐린 통계 한 줄입니다.m4.sh가 하는 일:
- 답변을 쓰는 대로 바로 보여 주고, 끝에 호스트, 런타임, 모델, 속도, 전체 시간을 흐린 한 줄로 표시합니다.
- 인수 없이 실행하면 대화를 이어 갑니다(
/new로 새 대화). - 파이프로 넘긴 텍스트도 받습니다:
cat notes.txt | m4.sh "이 내용을 요약해 주세요" - 모델에게 Markdown 대신 일반 텍스트로 답하게 하고, 남은
**는 지웁니다. - 현재 창 너비에 맞춰 단어 단위로 줄을 바꿉니다. 한글도 맞게 처리합니다.
zsh 설정 두 가지를 더하면 더 편해집니다. noglob 별칭을 쓰면 질문 끝에 ?를 붙여도 따옴표가 필요 없습니다. 그리고 Enter 키 훅이, 첫 단어가 명령이 아니면서 세 단어 이상이거나 ?로 끝나는 줄을 m4.sh로 보냅니다. 그래서 프롬프트에 질문을 바로 입력할 수 있습니다.
직접 써 보기
macOS에 원래 있는 m4 명령(빌드 도구가 사용합니다)과 겹치지 않도록 이름을 m4.sh로 지었습니다. macOS에 기본으로 있는 Python 3만 있으면 됩니다.
mkdir -p ~/bin
curl -o ~/bin/m4.sh https://ai.tchung.org/mlx-lm/m4.sh
chmod +x ~/bin/m4.sh

# ~/bin이 PATH에 없다면 (macOS 기본값에는 없습니다):
echo 'export PATH="$HOME/bin:$PATH"' >> ~/.zshrc && source ~/.zshrc

# 서버 이름이 mini-m4가 아니라면:
export M4_URL=http://YOUR-MAC:8080/v1/chat/completions

m4.sh "달은 지구에서 얼마나 멀리 있나요?"
그 밖의 설정: M4_MODEL(모델 이름), M4_MAX_TOKENS(기본 4096), M4_SYSTEM(직접 쓴 지시문, 비우면 Markdown 허용), M4_STATS=0(통계 줄 숨기기).
m4.sh 소스 (185줄)
#!/usr/bin/env python3
"""m4.sh — chat with the Qwen model on mini-m4 (mlx_lm.server :8080), no OpenCode.

  m4.sh                   interactive chat (keeps history; /new resets, /quit or Ctrl-D exits)
  m4.sh "question"        one-shot answer
  cat file | m4.sh "summarize this"   piped text is added to the prompt

Replies are plain text (no Markdown); M4_SYSTEM="" turns that off, or sets your own system prompt.
After each answer a stats line goes to stderr (M4_STATS=0 hides it).
"""
import json, os, re, shutil, sys, time, unicodedata, urllib.parse, urllib.request

URL = os.environ.get("M4_URL", "http://mini-m4:8080/v1/chat/completions")
MODEL = os.environ.get("M4_MODEL", "mlx-community/Qwen3.5-9B-4bit")
MAX_TOKENS = int(os.environ.get("M4_MAX_TOKENS", "4096"))
SYSTEM = os.environ.get("M4_SYSTEM",
    "Reply in plain text for a terminal. Do not use Markdown: no **bold**, no # headings, "
    "no tables. Use simple dashes for lists.")


class Unbold:
    """Removes ** from streamed text, even when a ** is split across two chunks."""
    def __init__(self):
        self.held = ""

    def feed(self, text):
        text = (self.held + text).replace("**", "")
        self.held = "*" if text.endswith("*") else ""
        return text[:-1] if self.held else text

    def flush(self):
        held, self.held = self.held, ""
        return held


def cells(s):
    """Terminal width of s (Korean/CJK characters take two cells)."""
    return sum(2 if unicodedata.east_asian_width(c) in "WF" else 1 for c in s)


class Wrap:
    """Word-wraps streamed text to the terminal width, so words are never split.
    List items ("- ", "1. ") wrap with a hanging indent."""
    def __init__(self, width):
        self.width, self.col, self.word, self.spaces = width, 0, "", ""
        self.hang, self.first = "", True

    def _word(self):
        out, w = "", self.word
        if not w:
            return out
        if self.first:                      # first word on this line: set hanging indent
            lead = self.spaces
            bullet = w in ("-", "*", "•") or re.fullmatch(r"\d+[.)]", w)
            self.hang = " " * (cells(lead) + (cells(w) + 1 if bullet else 0))
            out, self.col, self.first = lead, cells(lead), False
        elif self.col + cells(self.spaces) + cells(w) > self.width() and self.col > len(self.hang):
            out, self.col = "\n" + self.hang, len(self.hang)
        else:
            out, self.col = self.spaces, self.col + cells(self.spaces)
        self.word, self.spaces = "", ""
        self.col += cells(w)
        return out + w

    def feed(self, text):
        out = ""
        for ch in text:
            if ch == "\n":
                out += self._word() + "\n"
                self.col, self.spaces, self.first = 0, "", True
            elif ch in " \t":
                out += self._word()
                self.spaces += ch
            else:
                self.word += ch
        return out

    def flush(self):
        return self._word()


class NoWrap:
    def feed(self, text):
        return text

    def flush(self):
        return ""


def ask(messages):
    if SYSTEM:
        messages = [{"role": "system", "content": SYSTEM}] + messages
    unbold = Unbold()
    wrap = (Wrap(lambda: shutil.get_terminal_size().columns - 1)  # re-read per word: follows resizes
            if sys.stdout.isatty() else NoWrap())
    body = json.dumps({"model": MODEL, "messages": messages,
                       "max_tokens": MAX_TOKENS, "stream": True,
                       "stream_options": {"include_usage": True}}).encode()
    req = urllib.request.Request(URL, body, {"Content-Type": "application/json"})
    out, usage, first, meta = [], {}, None, {}
    start = time.monotonic()
    try:
        with urllib.request.urlopen(req, timeout=600) as r:
            for line in r:
                line = line.decode().strip()
                if not line.startswith("data:"):
                    continue
                data = line[5:].strip()
                if data == "[DONE]":
                    break
                chunk = json.loads(data)
                usage = chunk.get("usage") or usage
                meta.setdefault("model", chunk.get("model"))
                meta.setdefault("fp", chunk.get("system_fingerprint"))
                if not chunk.get("choices"):
                    continue
                delta = chunk["choices"][0].get("delta", {}).get("content") or ""
                if delta and first is None:
                    first = time.monotonic()
                delta = unbold.feed(delta)
                out.append(delta)
                print(wrap.feed(delta), end="", flush=True)
    except OSError as e:
        sys.exit(f"m4: can't reach {URL}: {e}")
    end = time.monotonic()
    tail = unbold.flush()
    out.append(tail)
    print(wrap.feed(tail) + wrap.flush(), flush=True)
    stats(usage, start, first, end, meta)
    return "".join(out)


def stats(u, start, first, end, meta):
    if os.environ.get("M4_STATS", "1") == "0":
        return
    first = first or end
    out, gen = u.get("completion_tokens", 0), end - first
    ver = (meta.get("fp") or "").split("-")[0]          # e.g. "0.32.2-..." -> mlx-lm 0.32.2
    model = (meta.get("model") or MODEL).split("/")[-1]  # drop "mlx-community/"
    host = urllib.parse.urlparse(URL).hostname
    parts = [host, f"mlx-lm {ver}".strip(), model]
    if out > 1 and gen > 0:
        parts.append(f"{(out - 1) / gen:.1f} tok/s")
    parts.append(f"{end - start:.1f}s total")
    dim = sys.stderr.isatty()
    print(("\033[2m" if dim else "") + "[" + " · ".join(parts) + "]" + ("\033[0m" if dim else ""),
          file=sys.stderr)


def main():
    prompt = " ".join(sys.argv[1:])
    if not sys.stdin.isatty():
        piped = sys.stdin.read()
        prompt = f"{prompt}\n\n{piped}" if prompt else piped
    if prompt.strip():
        ask([{"role": "user", "content": prompt}])
        return

    import readline  # noqa: F401  (line editing + up-arrow history)
    history = []
    print(f"m4.sh chat — {MODEL}  (/new to reset, /quit to exit)")
    while True:
        try:
            q = input("\n> ").strip()
        except (EOFError, KeyboardInterrupt):
            print()
            return
        if not q:
            continue
        if q in ("/quit", "/exit"):
            return
        if q == "/new":
            history = []
            print("(new conversation)")
            continue
        history.append({"role": "user", "content": q})
        try:
            history.append({"role": "assistant", "content": ask(history)})
        except KeyboardInterrupt:
            print("\n(interrupted)")
            history.pop()


if __name__ == "__main__":
    main()
질문을 바로 입력하게 해 주는 zsh 훅
alias m4.sh="noglob m4.sh"

_m4_rewrite() {
  local -a w; w=(${=1})
  (( ${#w} )) || return 1
  [[ ${w[1]} == */* || ${w[1]} == *=* || ${w[1]} == [\ \(\!\{\[]* ]] && return 1
  whence -- "${w[1]}" >/dev/null 2>&1 && return 1
  (( ${#w} >= 3 )) || [[ $1 == *\? ]] || return 1
  REPLY="m4.sh ${(q)1}"
}
_m4_accept_line() {
  _m4_rewrite "$BUFFER" && BUFFER=$REPLY
  zle .accept-line
}
zle -N accept-line _m4_accept_line
코딩 에이전트를 빠르게 만든 런처
채팅 질문은 수십 토큰이면 됩니다. 하지만 OpenCode 같은 코딩 에이전트는 매번 시스템 프롬프트와 도구 목록 전체, 약 9,300토큰을 함께 보냅니다. 프롬프트를 초당 약 220토큰으로 읽으니, 첫 글자가 나오기까지 40초 가까이 걸립니다.
mlx_lm.server는 이미 처리한 프롬프트 앞부분을 저장해 둡니다. 다음 요청이 같은 시스템 프롬프트와 도구 목록으로 시작하면 새로운 부분만 읽습니다. 그래서 opencode-m4라는 런처를 만들었습니다. OpenCode를 켤 때 뒤에서 미리 요청을 하나 보내 두기 때문에, 제가 실제 첫 질문을 할 때는 앞부분이 이미 저장되어 있습니다.
| 이전 | 런처 사용 | |
|---|---|---|
| 첫 질문에서 읽는 프롬프트 | ~9,300토큰 | ~20토큰 |
| 답이 시작되기까지 대기 | ~40초 | ~1초 |
| OpenCode에서 "달까지 거리" 질문, 전체 | 49.9초 | 23.2초 |
같은 질문을 m4.sh로, 전체 | 해당 없음 | 5.5초 |
OpenCode는 시스템 프롬프트에 작업 폴더와 오늘 날짜를 넣습니다. 그래서 폴더마다, 날마다 첫 세션은 언제나 40초 정도 걸리는 콜드 스타트입니다.
배운 점
- Ollama의
qwen3.5:9b-mlx는 Ollama 전용 저장소 형식이라 mlx-lm이 읽지 못합니다. Hugging Face에는-4bit,-nvfp4,-6bit,-8bit버전이 있습니다. - Hugging Face 캐시는 가중치를 공용
hub/blobs폴더에 저장하기 때문에, 모델 폴더 자체는 거의 비어 보입니다. 디스크 사용량은blobs에서 확인합니다. - Homebrew로 Ollama를 지울 때는
HOMEBREW_NO_AUTOREMOVE=1을 붙입니다. 그렇지 않으면mlx와 그것이 쓰는 Python까지 함께 지워집니다. - OpenCode 2.x는 공용 백그라운드 서비스를 거쳐 요청을 보내는데, 이 서비스가 네트워크의 서버에 접속하지 못했습니다.
--standalone으로 실행해서 해결했습니다. - 서버 로그의
BrokenPipeError는 클라이언트가 답변 도중 연결을 끊었다는 뜻일 뿐, 문제가 아닙니다. - mlx-lm은 텍스트 전용입니다. 이미지가 필요하면 비전 모델과 함께
mlx_vlm.server를 씁니다.
평소에 쓰는 명령
# 재시작 / 정지
sudo launchctl kickstart -k system/com.mlx-lm.server
sudo launchctl bootout system/com.mlx-lm.server

# 켜져 있는지, 어떤 모델인지
curl -s http://localhost:8080/v1/models

# 로그 보기
tail -f ~/Library/Logs/mlx-lm-server.log